Resume este artículo, encuentra los puntos clave o pregunta lo que quieras entender mejor.
El crawling es el proceso mediante el cual los motores de búsqueda recorren la web para descubrir URLs y acceder a su contenido. En Google, esta tarea la realizan rastreadores como Googlebot, que siguen enlaces, consultan sitemaps y vuelven a visitar páginas que ya conocen.
En español, crawling suele traducirse como rastreo web.
Es importante diferenciar rastreo de indexación. Que Google rastree una URL no significa que necesariamente vaya a incorporarla a su índice ni que vaya a posicionarla en los resultados.
Qué es crawling en SEO
En SEO, crawling es el proceso mediante el cual un buscador solicita y explora recursos disponibles en un sitio web.
Gracias al rastreo, Google puede descubrir:
- Páginas nuevas.
- Cambios en páginas conocidas.
- Enlaces hacia otras URLs.
- Redirecciones.
- Recursos necesarios para procesar una página.
Si una URL importante no puede ser descubierta o rastreada correctamente, será mucho más difícil que Google pueda procesarla para sus sistemas de búsqueda.
Qué significa crawling en español
Crawling puede traducirse como rastreo.
En el contexto SEO suele hablarse de:
- Rastreo web.
- Rastreo de Google.
- Rastreo de URLs.
- Rastreo de motores de búsqueda.
El término no debe confundirse con indexing, que significa indexación.
Qué es un crawler
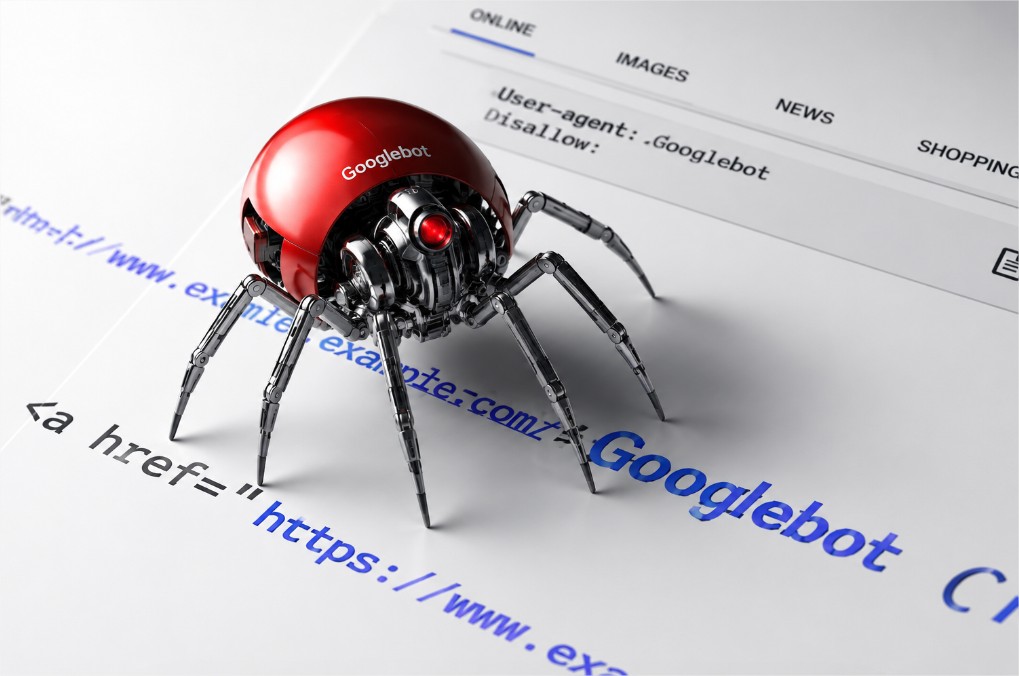
Un crawler es un programa automatizado que visita recursos siguiendo determinadas reglas.
También puede recibir nombres como:
- Bot.
- Robot.
- Spider.
- Rastreador.
Google utiliza diferentes rastreadores según sus productos. Para Google Search, el más conocido es Googlebot.
Qué es Googlebot
Googlebot es el rastreador utilizado por Google Search para descubrir y volver a visitar contenido disponible en la web.
Una forma simplificada de entender el proceso es:
- Google conoce una URL.
- Googlebot solicita el recurso.
- El servidor responde.
- Google procesa la información obtenida.
- Puede descubrir nuevas URLs mediante enlaces.
- Posteriormente, los sistemas de Google determinan qué contenido puede ser indexado.
No todas las URLs rastreadas terminan necesariamente dentro del índice de Google.
Diferencia entre crawling e indexación
Rastreo e indexación forman parte del funcionamiento de los buscadores, pero no son sinónimos.
| Crawling | Indexación |
|---|---|
| Google accede y rastrea una URL | Google procesa el contenido para determinar si puede incorporarlo al índice |
| Se descubren recursos y enlaces | Se analiza y organiza información del contenido |
| No garantiza indexación | Requiere que Google pueda procesar adecuadamente la página |
Por eso una página puede aparecer en Search Console como rastreada y, aun así, no estar indexada.
Qué es crawlability
Crawlability puede entenderse como la facilidad o posibilidad que tiene un rastreador para acceder a las URLs y recursos de un sitio.
La capacidad de rastreo puede verse afectada por aspectos como:
- Reglas de robots.txt.
- Errores del servidor.
- Problemas de enlaces internos.
- URLs inaccesibles.
- Autenticación obligatoria.
- Configuraciones técnicas incorrectas.
Una página que existe para el usuario no necesariamente está disponible del mismo modo para un rastreador.
Cómo descubre Google nuevas URLs
Google puede conocer URLs mediante distintas fuentes.
Enlaces internos
Permiten que Googlebot pase de una página conocida a otra URL del mismo sitio.
Enlaces externos
Un enlace desde otra web también puede ayudar a descubrir una dirección que Google todavía no conocía.
Sitemaps
Un sitemap XML permite proporcionar a Google una lista de URLs que el sitio considera importantes.
URLs conocidas previamente
Google también vuelve a visitar direcciones que ya forman parte de sus sistemas para detectar posibles cambios.
Qué es crawl depth
Crawl depth o profundidad de rastreo suele utilizarse en auditorías SEO para describir qué tan lejos está una página respecto a un punto de partida según los enlaces internos.
Por ejemplo:
- Inicio → profundidad 0.
- Categoría enlazada desde inicio → profundidad 1.
- Artículo enlazado desde esa categoría → profundidad 2.
Las herramientas SEO pueden calcular esta profundidad de formas ligeramente diferentes dependiendo de dónde comienzan el rastreo.
No debería interpretarse como un factor de ranking independiente.
Su utilidad está en detectar páginas importantes demasiado aisladas dentro de la arquitectura.
Por qué importa la profundidad de rastreo
Una arquitectura clara facilita que usuarios y rastreadores encuentren las páginas importantes.
Una URL situada a muchos enlaces de distancia puede indicar problemas como:
- Enlazado interno insuficiente.
- Categorías mal organizadas.
- Páginas huérfanas.
- Navegación excesivamente profunda.
No existe un número universal de clics que deba cumplir toda página.
La prioridad es que las URLs relevantes puedan descubrirse mediante una arquitectura lógica.
Qué es crawl budget
Crawl budget significa presupuesto de rastreo.
Google lo describe como el conjunto de URLs que puede y quiere rastrear dentro de un sitio.
Está determinado principalmente por dos componentes:
- Capacidad de rastreo cuánto puede rastrear Google sin perjudicar el servidor.
- Demanda de rastreo cuánto interés existe en volver a rastrear determinadas URLs.
La demanda puede variar según factores como cambios en el contenido, relevancia, popularidad y cantidad de URLs conocidas.
Todos los sitios deben optimizar el crawl budget
No.
Para la mayoría de sitios pequeños y medianos, el presupuesto de rastreo no debería convertirse en una preocupación diaria.
Este análisis es especialmente relevante para sitios muy grandes, plataformas con decenas de miles o millones de URLs y webs cuyo contenido cambia constantemente.
En un sitio convencional suele ser más útil concentrarse en:
- Buena arquitectura.
- Enlaces internos.
- Sitemaps actualizados.
- Evitar errores técnicos.
- No generar URLs innecesarias.
Qué factores afectan el crawl budget
Entre los elementos que Google considera se encuentran la capacidad del servidor y la demanda de rastreo.
También pueden generar ineficiencias:
- Grandes cantidades de URLs duplicadas.
- Parámetros innecesarios.
- Navegación facetada sin control.
- Soft 404.
- Cadenas largas de redirecciones.
- Respuestas lentas del servidor.
- Errores 5xx o limitaciones 429.
No es preciso reducir el concepto a una supuesta puntuación de autoridad del dominio.
Qué función cumple robots.txt en el crawling
El archivo robots.txt permite establecer reglas sobre qué rutas pueden o no rastrear determinados bots compatibles.
Por ejemplo:
User-agent: Googlebot
Disallow: /zona-privada/
Esto puede impedir que Googlebot rastree las URLs comprendidas en esa ruta.
Sin embargo, robots.txt controla principalmente el rastreo, no es el método adecuado para garantizar que una URL desaparezca del índice.
Una URL bloqueada puede seguir siendo conocida por Google a través de otros enlaces.
Google utiliza crawl delay
Googlebot no admite la directiva crawl-delay dentro de robots.txt.
Por tanto, una configuración como:
Crawl-delay: 10
no modifica la frecuencia de rastreo de Googlebot.
Otros rastreadores pueden interpretar esta directiva de forma diferente, por lo que siempre debe revisarse la documentación de cada bot.
Diferencia entre robots.txt y noindex
Estas instrucciones tienen objetivos diferentes.
robots.txt controla si un rastreador puede solicitar determinadas URLs.
noindex indica que una página no debería incluirse en el índice.
Para que Google pueda detectar una etiqueta noindex, debe poder rastrear la página.
Bloquear primero una URL mediante robots.txt puede impedir que Google lea esa instrucción.
Qué función tiene un sitemap XML
Un sitemap ayuda a informar a los motores de búsqueda sobre URLs que el sitio considera relevantes.
Puede ser especialmente útil en:
- Sitios grandes.
- Webs nuevas.
- Sitios con pocas conexiones externas.
- Proyectos con grandes cantidades de contenido.
- Páginas nuevas o actualizadas con frecuencia.
Incluir una URL en un sitemap no garantiza que vaya a indexarse.
El sitemap facilita el descubrimiento, pero Google todavía debe rastrear y evaluar el contenido.
Explora nuestros servicios o cuéntanos qué necesitas mejorar.
Convierte lo que aprendes en el siguiente paso de tu negocio
Cómo afecta JavaScript al crawling
Google puede procesar páginas que utilizan JavaScript, pero el acceso a los recursos necesarios y la respuesta del servidor siguen siendo importantes.
Los problemas aparecen cuando el contenido relevante:
- Solo aparece después de interacciones complejas.
- Depende de recursos bloqueados.
- No utiliza URLs rastreables.
- Falla durante la ejecución.
- Está detrás de autenticación.
Server-side rendering o prerenderizado pueden resultar útiles en determinados proyectos, pero no deberían presentarse como requisitos obligatorios para cualquier web desarrollada con JavaScript.
Qué es un análisis de logs SEO
Los logs del servidor registran solicitudes realizadas al sitio.
Analizarlos permite comprobar cómo interactúan realmente diferentes bots con las URLs.
Un análisis puede ayudar a conocer:
- Qué URLs solicita Googlebot.
- Con qué frecuencia.
- Qué códigos de estado recibe.
- Qué zonas reciben poco rastreo.
- Dónde aparecen errores de servidor.
Esto puede ser especialmente útil en sitios grandes donde un rastreo simulado con una herramienta SEO no muestra necesariamente todo el comportamiento real de Googlebot.
Cómo mejorar el crawling de una web
No se trata de conseguir que Googlebot visite el mayor número posible de URLs.
El objetivo es facilitar el descubrimiento y rastreo de las páginas que realmente importan.
Conviene revisar:
- Arquitectura del sitio.
- Enlaces internos.
- Robots.txt.
- Sitemaps.
- Códigos HTTP.
- Redirecciones.
- URLs duplicadas.
- Parámetros.
- Respuesta del servidor.
- Problemas de JavaScript.
Para sitios grandes también puede resultar necesario estudiar estadísticas de rastreo y registros del servidor.
Errores frecuentes al analizar crawling
- Confundir rastreo con indexación.
- Pensar que una URL rastreada tiene que indexarse.
- Obsesionarse con crawl budget en un sitio pequeño.
- Utilizar robots.txt para intentar desindexar páginas.
- Bloquear recursos necesarios sin revisar sus efectos.
- Asumir que crawl depth es un factor directo de ranking.
- Crear grandes cantidades de URLs mediante filtros o parámetros.
- Utilizar crawl-delay esperando controlar Googlebot.
- Interpretar cualquier 404 como un problema de presupuesto de rastreo.
Cómo analizar crawling desde Search Console
Google Search Console dispone de diferentes informes y herramientas útiles para estudiar el rastreo.
Entre ellos pueden utilizarse:
- Inspección de URLs.
- Informe de indexación de páginas.
- Estadísticas de rastreo.
- Sitemaps.
Search Console permite estudiar lo que Google conoce de un sitio, mientras una herramienta de crawling externa simula un recorrido propio.
Ambas perspectivas son útiles, pero no representan exactamente lo mismo.
Qué debemos revisar primero en una auditoría de crawling
Una auditoría puede comenzar respondiendo preguntas sencillas:
- ¿Google puede acceder a las páginas importantes?
- ¿Las URLs principales están enlazadas internamente?
- ¿El servidor responde correctamente?
- ¿robots.txt bloquea algo que debería rastrearse?
- ¿El sitemap contiene URLs válidas?
- ¿Existen grandes cantidades de URLs duplicadas o innecesarias?
- ¿Las páginas importantes se encuentran demasiado aisladas?
Solo después tiene sentido profundizar en temas avanzados como presupuesto de rastreo y análisis de logs cuando el tamaño y comportamiento del sitio realmente lo justifican.
Preguntas frecuentes sobre crawling en SEO
Qué es crawling
Es el proceso mediante el cual los motores de búsqueda utilizan rastreadores automatizados para descubrir URLs y acceder a sus contenidos.
Qué significa crawling en español
En el contexto SEO, crawling suele traducirse como rastreo web.
Qué es un crawler
Es un programa automatizado que visita recursos y sigue enlaces según determinadas reglas. También puede denominarse bot, spider o rastreador.
Qué es Googlebot
Es uno de los rastreadores utilizados por Google para descubrir y volver a visitar contenido disponible en la web.
Crawling e indexación son lo mismo
No. Crawling se refiere al rastreo de una URL. La indexación ocurre posteriormente y una página rastreada no tiene garantizada su inclusión en el índice.
Qué es crawl depth
Es una medida utilizada en auditorías para representar la distancia de una URL respecto a un punto de partida según el número de enlaces necesarios para llegar a ella.
Qué es crawl budget
Es el conjunto de URLs que Google puede y quiere rastrear dentro de un sitio, determinado principalmente por la capacidad y la demanda de rastreo.
Todos los sitios necesitan optimizar crawl budget
No. Es una preocupación principalmente para sitios muy grandes, proyectos que cambian constantemente o webs con grandes cantidades de URLs pendientes de rastreo.
Google admite crawl delay
No. Googlebot no admite la directiva crawl-delay dentro del archivo robots.txt.
Robots txt sirve para desindexar páginas
No es su función principal. Robots.txt controla el rastreo. Si necesitas que Google lea una directiva noindex, la página debe poder ser rastreada.
Qué es crawlability
Es la capacidad o facilidad con la que un rastreador puede acceder a las páginas y recursos de un sitio.
Un sitemap garantiza la indexación
No. Ayuda al descubrimiento de URLs, pero Google todavía debe rastrear y evaluar cada página antes de decidir si la indexa.